上一篇文章提到,在下最近又重新開始玩起了Stable Diffusion。重拾手感(?)之後,搭配各式各樣的LoRA,生成喜歡的二次元角色真的非常方便,差別只在於Lora的完成度而已。只不過,這陣子始終有一件事情讓在下相當苦惱,那就是人物的姿勢(Pose)的穩定性。
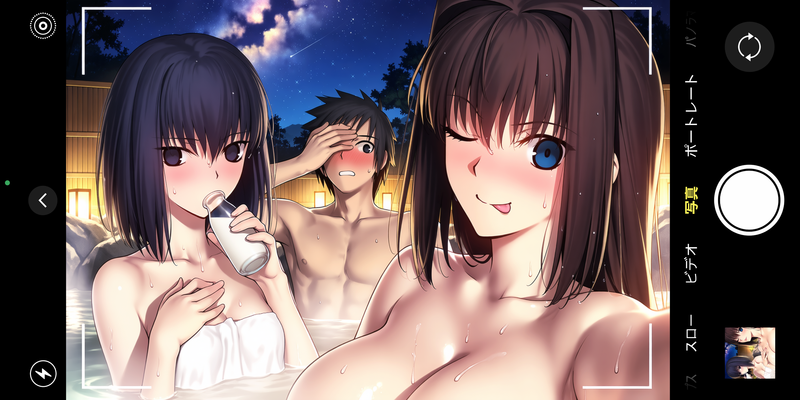
相信有玩過AI繪圖的人應該都知道,想讓角色擺出某個特定姿勢,光靠Prompt往往不是那麼容易。就譬如希望她一手托著下巴,另一手拿筆寫字,Prompt並不難寫,但生成出來的構圖卻常常不是那麼回事。好不容易抽到一張稍微滿意的,偏偏手指又變成六根。如果再追加一些Negative Prompt試圖去修正它的話,下一張圖有可能連稍微滿意的姿勢都跑掉了。到頭來,往往只能從眾多不滿意的結果裡,挑一張自己比較能接受的圖片_(:3 」∠)_
前幾天在X上閒逛時,偶然發現了Anhao的AI Pose Gallery專案。這是一套整合人像、服裝與人物姿勢的參考資料庫,可以透過呼叫AI將不同的素材組合來生成圖片。一開始看到的時候,由於人像與服裝素材主要偏向寫實系,個人並不是很感興趣。
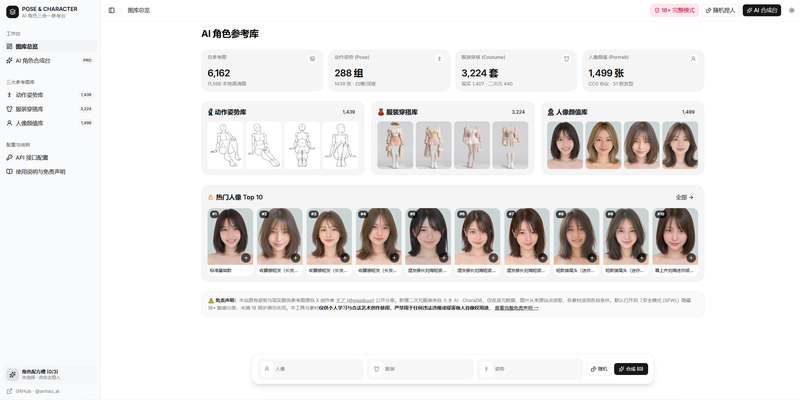
隨便RUN了一下之後,發現它的姿勢圖片異常豐富,約有288組不同姿勢,而且同一個動作還提供正面、俯視、仰視、側面及斜側等不同角度,圖片高達1,439張。稍微査了一下,這些姿勢圖片其實來自日本的ポーズ集 データベース,原作者是ギア氏。Anhao的專案則將這些素材整理以及中文化,並整合進自己的圖片生成工具中。
此時在下突然念頭一轉,如果可以直接從Stable Diffusion選擇這些姿勢圖片,然後送進ControlNet的話,是不是也能生成相同姿勢的圖片呢?
那說起ControlNet,雖然很早就聽過這個東西,Forge Neo也已經內建相關功能,但在下卻一直沒有認真研究過。畢竟什麼Canny、OpenPose、Depth之類的,看了就覺得有點讓人退縮。既然現在有了不錯的素材,不如就趁這個機會,請Codex和Claude Code幫忙開發一個適合Stable Diffusion Forge Neo的外掛,在下也可以順便學習一下ControlNet的用法這樣子w
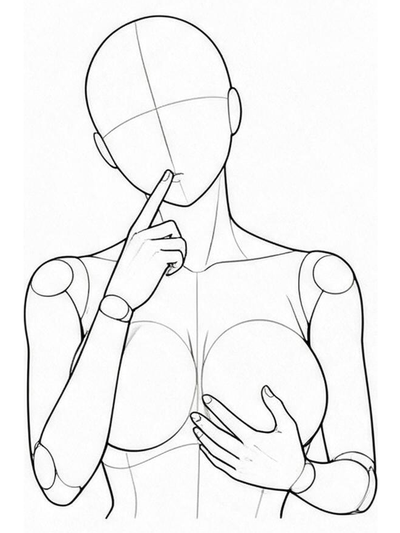
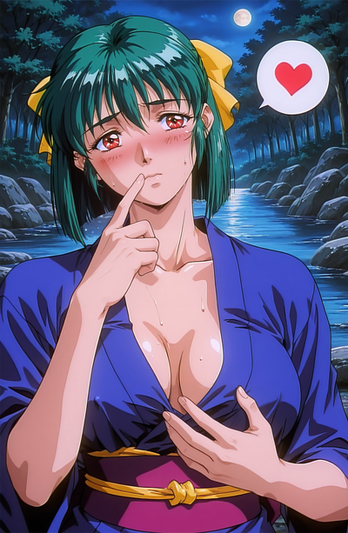
目標很簡單,基本上就是製作一個可以瀏覽、選擇Pose圖片,並直接送進ControlNet的小工具。藉由Codex和Claude Code強大的Coding能力加持,不到半天就把最初的雛形搞出來了,而且效果比預期的還要好。原來ControlNet真的可以讓生成的圖片忠實地參考指定姿勢,差別主要在於控制的強度而已。
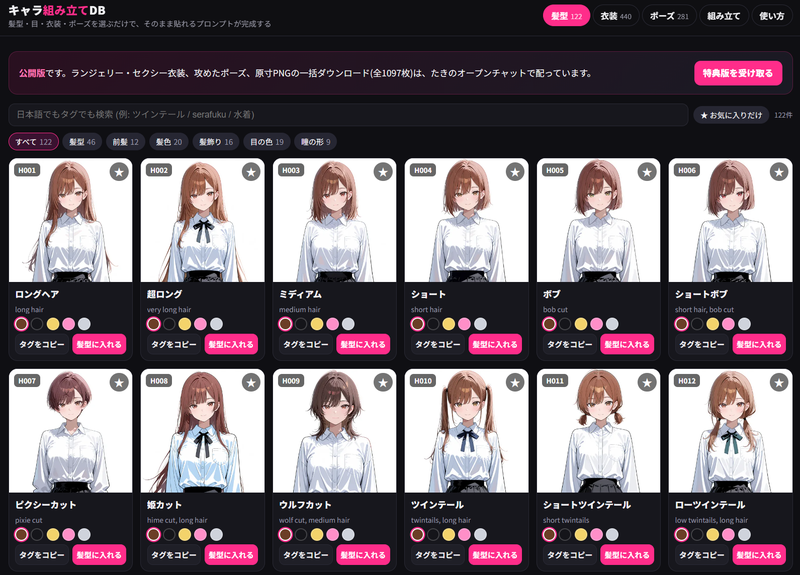
然後在下又循著AI Pose Gallery的README.md,挖到了キャラ組み立てDB(CharaDB),原作者是taki-ttt氏。這個資料庫不僅有髮型、眼睛、服裝等素材,還直接附上對應的Danbooru Tags,甚至它的範例全部都是二次元動漫圖片,非常符合在下的胃口,所以就順便把它整合了進來。
之後,在下又心血來潮地追加了自訂圖片的功能(Custom Poses)。畢竟除了上述的ポーズ集 データベース之外,網路上其實還有不少類似的姿勢參考圖庫,例如WaveSpeed的AI Pose Templates。
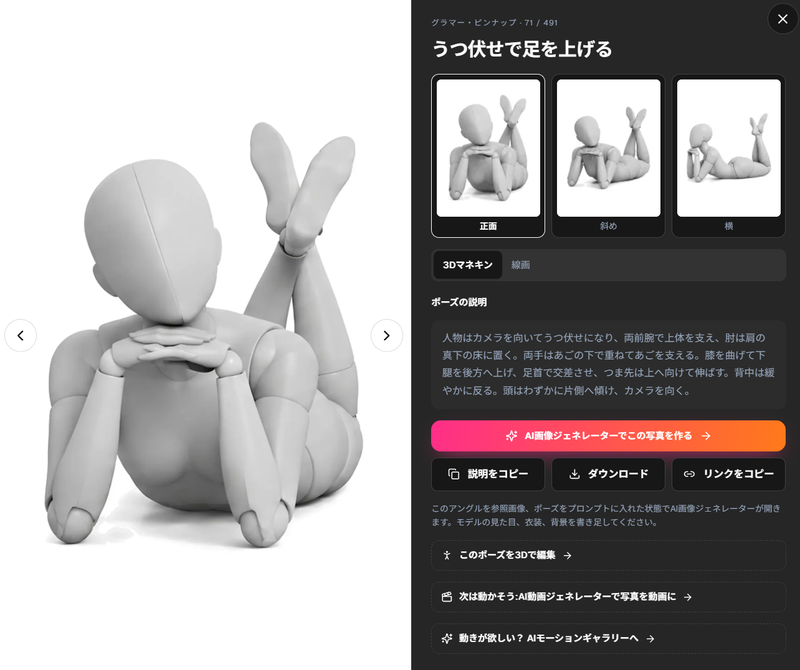
由於這類網站往往只能在網頁上一張一張瀏覽,挑選自己喜歡的姿勢後再個別下載,無法把整套圖片一次打包帶走。既然如此,乾脆在外掛裡增加一個收藏庫,將下載來的姿勢圖片直接上傳、保存及管理,未來想到的時候便可以隨時選取,並傳送至ControlNet生成圖片,豈不更一勞永逸?
在新增這個功能的時候,反而把當初沒打算作的東西加進來了。依照Claude Code的建議,這個工具在上傳圖片時可以指定它是一般的姿勢參考圖、已經處理好的Canny線稿、OpenPose骨架、或者是Depth map,系統會依照類型決定要不要跑預處理。當初在下覺得複雜,只想對應最符合這些姿勢圖片的Canny,不過一般常見的OpenPose骨架圖,也是可以直接拿來用就是了。
AI常常會建議你覺得沒必要,但又沒理由拒絕的東西,相信很多人都跟在下有同樣的感覺吧(笑
那這幾天實際使用後,在下又覺得當初從AI Pose Gallery順便整合進來的服裝資料庫,對自己的使用習慣而言,總有一股莫名的違和感。一來這些圖片主要屬於「寫實系」,二來每件衣服附帶的提示詞基本上都大同小異…畢竟這些衣服原本的用途是讓AI直接參考服裝圖片進行合成,內建的文字描述自然不需要太詳細,但拿來當作Stable Diffusion的Prompt,就不是那麼實用了。
尤其在下主要生成的都是二次元動漫人物,能參考的範圍實在有限,既然已經有了CharaDB,索性又把Anhao的服裝資料庫從外掛中移除了,省得佔空間。
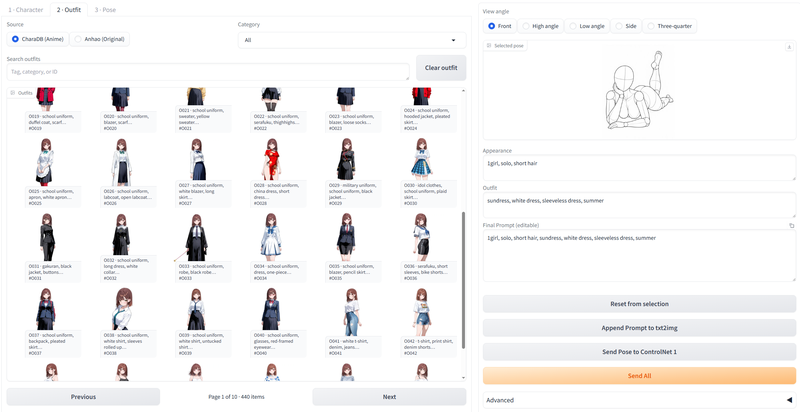
經過以上種種折騰,原本只是單純選擇姿勢的小工具,一時無心插柳柳成蔭,就變成了一個可以選擇髮型、髮色、眼睛、服裝,再搭配指定姿勢,自動組合Prompt的Forge Character Builder。
使用方法倒也不複雜,選好想要的角色特徵、服裝與姿勢後,按下「Send All」,外掛就會把產生的Prompt追加到txt2img,並將姿勢圖片傳送至ControlNet Unit 1。而原本就存在Prompt欄的角色LoRA、Prompt以及Negative Prompt都會原封不動地保留,不需要從頭再複製貼上一次。
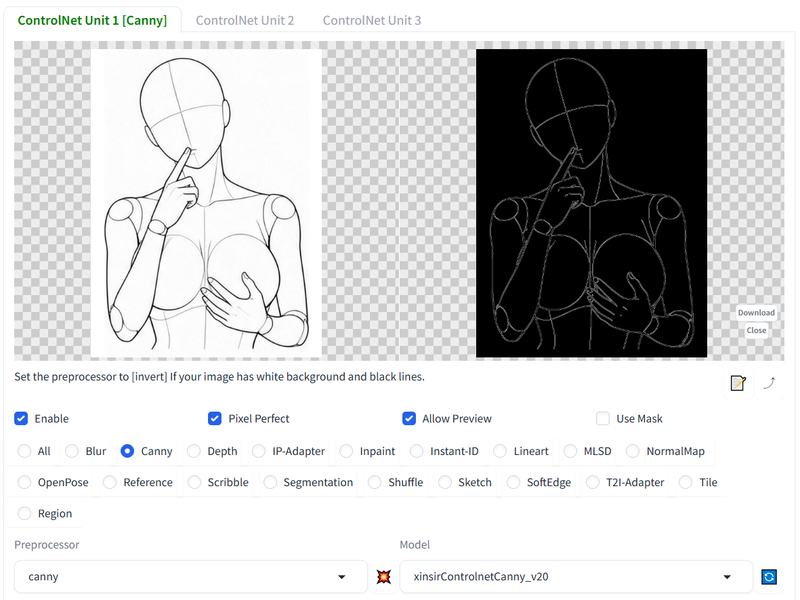
至於ControlNet的部分,一般姿勢參考圖會自動把Preprocessor設成Canny,而Depth圖因為本身已經是處理完成的控制圖,因此會將Preprocessor設為None,避免重複進行預處理。不過ControlNet模型仍然需要自行選擇,Depth圖也必須搭配相容的Depth模型。這裡大概是初學者最常卡住的地方——在下用的Xinsir Canny V2是SDXL專用的,如果你的Checkpoint是SD 1.5,就必須另外找一顆SD 1.5的Canny模型,不然可能無法正常生成,甚至直接跳Error(ry
唯一比較可惜的是,目前Prompt的組合功能還有一些改善空間,尤其姿勢部分主要還是交給ControlNet處理,並不會自動產生對應的動作描述。這部分等未來有時間再慢慢改善吧…
目前外掛已經放到GitHub,最新版本為v1.7.0 Beta,有興趣的人可以自行下載試用。
要特別說明的是,這個外掛並沒有內建上述資料庫的圖片素材,必須自行從CharaDB與Anhao的專案下載。如果只想使用Custom Poses,也可以直接上傳自己的姿勢圖,不需要安裝Anhao圖庫。另外,這是針對Forge Neo開發的外掛,其他版本的Stable Diffusion WebUI並未實際測試。安裝方式、素材放置位置與詳細設定都寫在GitHub的README裡,就不在這邊贅述了。
話說回來,當初想做的明明只是一個「選圖送 ControlNet」的小工具,結果現在回頭一看,程式碼已經四千三百多行,測試也寫了兩百七十幾個。讓AI幫忙寫Code實在是太好太強大,你們可以不要什麼都這麼專業好嗎( ̄▽ ̄;)
まあ、以上就是本次作戰的成果。
題外話,這陣子在X上貼的圖,感覺瀏覽數量都異常地少,放了好幾天通常也只有100~200次左右的曝光次數…跟上個月相比,真是不可同日而語。這演算法實在好謎,可能是圖片太色的關係吧…
嗯,肯定是的XD



LEAVE A COMMENT