どうも、和製ホーリックスです。
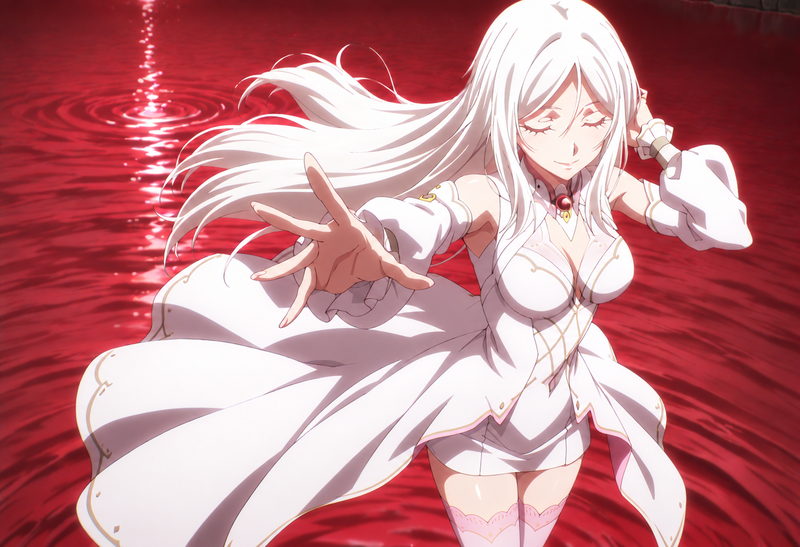
話說上一篇転スラ的動畫感想文中有提到,個人很喜歡原初之白的テスタロッサ,由於那時在X上感覺她的AIイラスト似乎沒有很多,正好Civitai已有強者製作出她的LoRA,想說既然網路上沒幾張,那就在下就自己來DIY一下,所以便啟動了許久未動的Stable-Diffusion-WebUI。
去年入手的NVIDIA RTX 5060 Ti 16GB雖然生成影片慢到不行,但是在出圖方面倒是非常快,藉由提示詞的不斷修正,很快地就生成了幾十張圖,在下就很索性的選了一張自己比較滿意的貼到X上去,沒想到這個無意舉動,居然讓在下進入了一個永無止境的精神時光屋了…Orz
今後とも忠誠を誓うこと、是非ともお許しくださいませ。
#テスタロッサ #転スラ https://t.co/DaZCmIeEvo— 和製ホーリックス (@Horlicks_p) September 13, 2026
是的,你沒看錯。不知道是不是因為大家的想法都跟在下一樣的關係,這張テスタロッサAIイラスト只稍微帶點色氣而已,但X友的迴響卻比以往在下所貼的任何一張糟糕圖還要來得強大。不僅瀏覽次數高達3.5萬次以上,還獲得了超過2,600個讚。這個結果著實讓在下有點始料未及,要不是很早之前就已經關掉X的App通知的話,這提示音應該是會跳整晚吧…(汗
「今夜の報告は私一人だけで行わせていただきますわ。みんなには……内緒、ですよ?」
#転スラ #テスタロッサ https://t.co/v0ftHBkYWm— 和製ホーリックス (@Horlicks_p) September 15, 2026
過了2天,在下又上傳了一張大概微調了一個晚上才滿意的テスタロッサAIイラスト,もちろん這次在色氣方面自然強化了些許…果不其然的,這次瀏覽次數甚至高達13萬次以上,並且獲得了7,000以上個讚,迴響遠遠超越了上一張圖。
「ドレスが肌に張り付いて、少し動きづらいのですわ。……ねえ、脱がせてくださる?」
#テスタロッサ #転スラ https://t.co/6ecRFCX39v— 和製ホーリックス (@Horlicks_p) September 19, 2026
也許是食髓知味,亦或是這般熱烈的迴響激發了在下塵封已久的創作欲吧。但是第3張テスタロッサAIイラスト的完成,卻足足讓在下搞了2天。果然有了目的之後,創作就不太順利了…雖然仍有得到6000個以上的讚,但瀏覽次數僅5.8萬,可能是太色了,所以無形中被X的演算法偷偷限流也說不定吧XD
まあ、以上的內容全部都是題外話(拖
今天主要想介紹的是,「Stable-Diffusion-WebUI-Neo」(Forge Neo)這個玩意。它是基於Stable Diffusion WebUI Forge所延伸的分支。由於原Forge版在2024年經過大幅重構,並加入FLUX.1模型支援後,後續的核心開發逐漸趨緩,因此便有其他開發者接手延伸,推出了持續更新的Forge Neo分支。
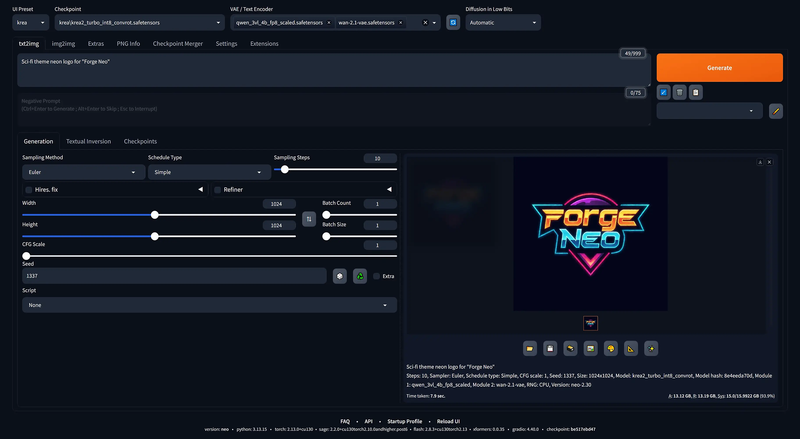
這個Forge Neo分支不僅升級了底層核心,同時延續了經典熟悉的AUTOMATIC1111介面,更能順暢運行當前最新的各類大型與前沿AI模型,包含最新的Qwen-Image-2.1系列。
老實說個人完全沒用過Forge版,在下是從無印的AUTOMATIC1111版直接跳到Forge Neo版。至於為什麼會突然找Forge Neo來用,主要還是因為在下無意間在Civitai上發現了不少90年代的經典糟糕動畫如《ワーズ・ワース》、《ミッドナイトパンサー》等劇中登場人物的LoRA。
由於這些LoRA使用的底模幾乎都是ANIMA系列,與傳統SDXL不同,無印的Stable-Diffusion-WebUI並無法直接使用。在下所知道的支援環境,基本上也只有ComfyUI而已。
然而ComfyUI自某次大幅更新,Logo底色從藍色變成黑色之後,不僅啟動程式的時間增加了不少,個人也覺得越來越難用。並不是說它不強大,而是這玩意兒感覺比較玄人志向,對於一向講求速成的在下,從零開始學習這件事基本上就是個門檻。然後它的強項主要還是在影片的生成,但NVIDIA RTX 5060 Ti 16GB光生成一個640×640解析度的5秒影片少說要花360秒以上,因此多少也讓在下有點不太想用。
雖然這可能取決於模型與生成設定,不過若要毫無顧忌地爽玩個大型影片生成模型,個人感覺GPU的VRAM至少得有32GB以上,才會比較盡興吧(´_ゝ`)
況且在下主要的目的是生成AI圖片的話,說真的,用ComfyUI反倒沒什麼效率,感覺用Stable-Diffusion-WebUI還比較快。也因此,在下索性問了ChatGPT有無支援ANIMA系列的模型,然後又是Stable-Diffusion-WebUI介面的玩意,它便建議在下不妨使用目前仍持續更新中的Forge Neo。
那說到Forge Neo,不愧是仍持續更新的專案,同樣條件下生成SDXL系列的圖片大致上就比無印快了約1-2秒左右。不過在生成ANIMA系列的圖片方面,則會比SDXL系列慢個3-5秒甚至更多。有可能是模型本身所使然吧,在下用ComfyUI跑也是差不多時間就是了。
此外,Forge Neo的開發者最近也因應需求,推出了支援Qwen-Image-2.1的版本。まあ、Qwen-Image-2.1的語言理解能力雖然極其強大,不過目前針對特定動漫人物的LoRA資源還不像SDXL或ANIMA那麼豐富,若想還原特定角色的造型,恐怕得充分利用它強大的自然語言理解能力,透過詳細的Prompt來「催眠」模型才行吧。因此對於講求速成的在下而言,目前還沒實際玩過就是了(ry
再來說說這個一整個月重拾AIイラスト生成的心得。
首先是當前的模型,真的要比以往「聰明」了不少,特別是在生成糟糕色圖方面。就算你提示詞下得不完整,大致上它還是有辦法生成出不錯的東西。此外圖片中突然冒出另外一個頭或分身的機率也降低了不少。手指、腳趾的部分,six fingers或six toes的情況雖然時有所見,但還是可以透過「抽卡」的方式來改善。當然,要生成滿意的圖片,最花時間的也是這個部分,特別是當畫面中有2個以上的人物,而且每個人的手指與腳趾都必須清楚呈現時,還是有機會抽卡抽到死還是抽不到XD
「シルバーウィーク最後の夜……これで、満足?明日からまた、励みなさい。」
#久遠寺有珠 #魔法使いの夜 https://t.co/MkRNbzmHs9— 和製ホーリックス (@Horlicks_p) September 23, 2026
もちろん、真的都沒辦法的話,還是可以請ChatGPT、Grok或Gemini來幫你修,只不過稍微露骨一點的圖,可能就要靠點運氣了,被果斷拒絕乃是家常便飯。通常在下都是萬中選一挑張miss最少的,然後自己用Photoshop來修這樣子。
再來就是提示詞,這也是個人這次最大的收穫,尤其是「鏡頭角度」與「人物姿勢」的部分。
可能是以前在下太懶了,總是一味複製貼上,從來不曾動腦去思考,明明就加了這個鏡頭角度的提示詞,但想要呈現的畫面與實際輸出的內容卻往往大相逕庭。後來才知道,有問題的並非提示詞本身,而是應從提示詞是否有必要存在,以及與其他提示詞之間有沒有衝突的方向來改善。
就譬如在下想呈現一個女孩的背影,通常我們鏡頭會用from behind,但實際輸出時,女孩總是會回頭,甚至依然是正面照,原因何在?
問題就在於,其他提示詞當中,是否出現了與女孩正面有關提示詞罷了。
譬如brown eyes、blush、light smile等,這些原本必須從正面才能看到的特徵,一旦與from behind同時存在,模型就有可能為了滿足所有提示詞,擅自讓女孩回頭,甚至直接生成正面照。換言之,並不是from behind這個提示詞沒有效果,而是自己下的其他提示詞正在互相扯後腿罷了。此外,你還要記得加上只有從女孩背面才看得到的特徵,如ass之類的。
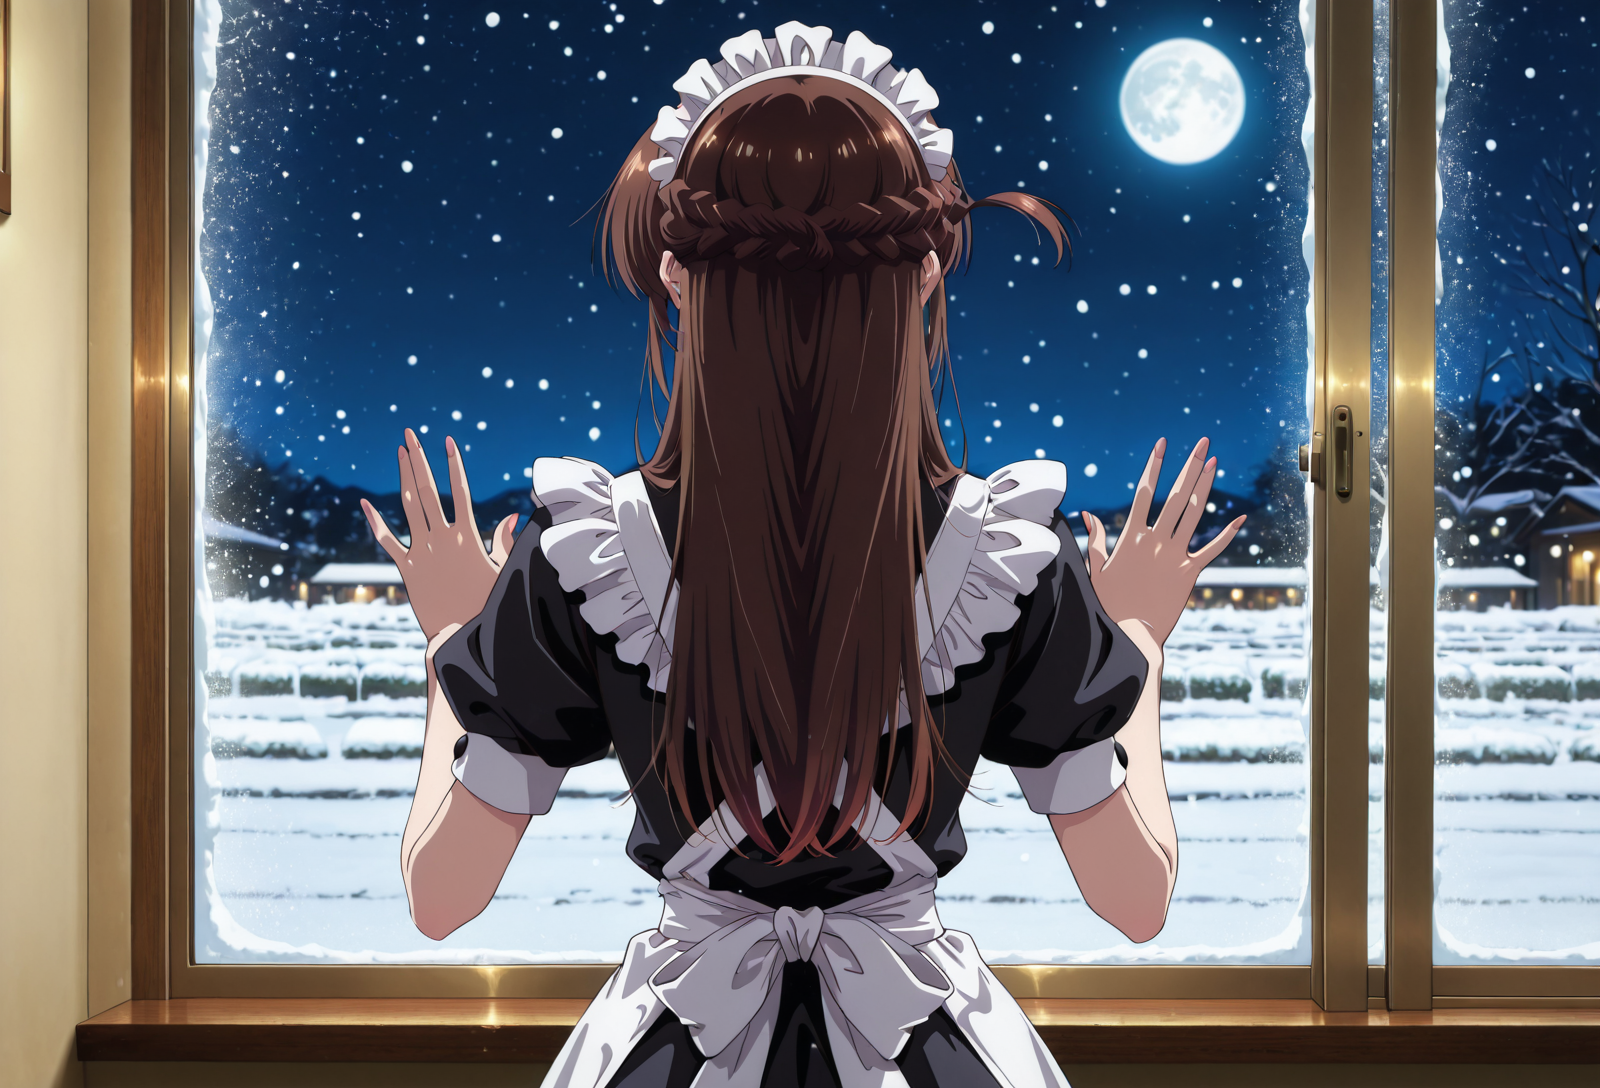
同理,當你設定的鏡頭是upper body,但提示詞卻出現女孩的legs、feet、toes,想當然你可能還是只會看到full body。即使圖片尺寸設定為原生尺寸如1216×832,還是有可能因為塞不下下半身,模型乾脆直接給你生出2個人來。這個邏輯在下一直以來都沒去認真思考,現在想想,真的是太該死了(跪
另外一個收穫就是,當一張圖片有3個以上的人物存在時,你要怎麼透過提示詞去讓每個人穿著與姿勢,是你所設定的?這個問題亦是困擾了在下許久。如果僅只有2個人的話,我們還是可以透過抽卡的機制來抽到想要的,但3個人以上的話,即便LoRA的影響再強,髮型不對,眼睛顏色不對,衣服穿著亂跳的情形更難以掌握。
就像在下想讓《美少女戦士セーラームーン》中較喜愛的3位角色同框,提示詞是怎麼改怎麼崩壞Orz
後來在Claude的建議之下,在下找到了SD Forge Attention Couple,這玩意兒的缺點就是會讓生成圖片的速度延遲個5-8秒,但整體來說確實是有效果的。然而以Stable Diffusion的能力而言,終究有其極限。在下測試了上百張圖,能穩定輸出的至多也就3人左右,4人同框的話還是需要一點運氣。
5人以上的話,可能ComfyUI會比較有辦法也說不定吧。
關於提示詞內容的部分,特別是生成人物方面,在下在網路上有找到不錯的Google sheet,有興趣的人不妨參考看看。いろんな意味で個人是受益良多(謎
星空の下で、大好きなキミへ届ける特別なメッセージ❤
#美少女戦士セーラームーン #セーラームーン #愛野美奈子 #セーラーヴィーナス #セーラーサターン #セーラーネプチューン https://t.co/4lVcM0C6zX— 和製ホーリックス (@Horlicks_p) October 11, 2026
もちろん你也可以問AI,但真心不建議你問Claude。它的防禦機制實在太過敏感,即使只是普通的二次元一般向圖片,提示詞中也沒有任何露骨或不適當的內容,它還是有可能因為原作角色的年齡設定而拒絕回答喔。就如上面的《美少女戦士セーラームーン》這張圖,在下明明只是請它幫忙整理一下Prompt當中重複出現的choker、brooch、jewelry等提示詞,連pantyshot這種輕微擦邊球的提示詞還都沒想到要寫,這傢伙居然二話不說就拒絕回答了(ノ`Д´)ノ︵ ┻━┻
馬的,我根本還沒上車啊XD
まあ、總而言之,最近在下班有空的時候都是在玩AIイラスト。畢竟目前在Civitai上的LoRA實在是太豐富了,然後不斷嘗試一些高難度的動作以及鏡頭事實上還蠻有趣的,也許還會持續好一陣子吧。
ではでは。



LEAVE A COMMENT